今天在 Hacker News 上翻当天的新文章,看到一篇挺对胃口的 preprint:它没有讲"模型又强了多少",而是讲一个更工程化的问题——当 AI 要在 C/C++ 这种构建依赖极重的代码库里改东西时,它到底该从哪里知道"改动属于哪里"?
这篇东西值得认真读一遍。
原文信息
- 标题:ByteAsk: Build-Aware Context and a Checking Harness for C++ Coding Agents
- 作者:Pratyush Saini(CTO, ByteAsk Research)、Anirudha Kulkarni(CEO, ByteAsk Research)
- 发布时间:2026 年 11 月 9 日(Hacker News 提交时间为 2026-11-10 00:39 UTC,北京时间 11 月 10 日上午)
- 原文链接:https://byteask.ai/research/byteask-system-cpp
- 代码与数据:https://github.com/ByteAsk/byteask-system-cpp
- HN 讨论:https://news.ycombinator.com/item?id=50434555
- 性质:厂商研究团队的 preprint,四页,未经过同行评审
先把这个前提说清楚:这是一家做 C/C++ 编码 Agent 的公司发布的自评研究。它给出的数字很漂亮,但"厂商自评"这四个字,决定了我们应该怎么读它。
它想解决什么问题
原文的出发点很朴素,但很少被认真对待:
Most of this progress, however, has concentrated on a few widely used languages, Python above all.
中文意思是:过去几年编码 Agent 的进步,主要集中在 Python 这类流行语言上,而 C/C++ 被探索得少得多。可 C/C++ 恰恰是操作系统、浏览器、数据库、嵌入式这些基础设施的语言,而且它们的代码库通常又大又依赖构建系统——这正是 Agent 最容易"找不到改动该放哪"的场景。
作者的说法是,Agent 在 C++ 里卡住,往往不是因为不会写代码,而是因为不知道这段代码在项目里处于什么位置:改哪个文件、还有哪些地方要做同样的改动、改完该跑哪些测试。这些信息,人靠经验补,Agent 则要靠上下文补。
方法:让上下文引擎"按构建的方式"理解代码
ByteAsk 的核心不是换模型,而是在模型动手之前先做三件事。
At its core is a context engine that understands a codebase the way the project's own build does.
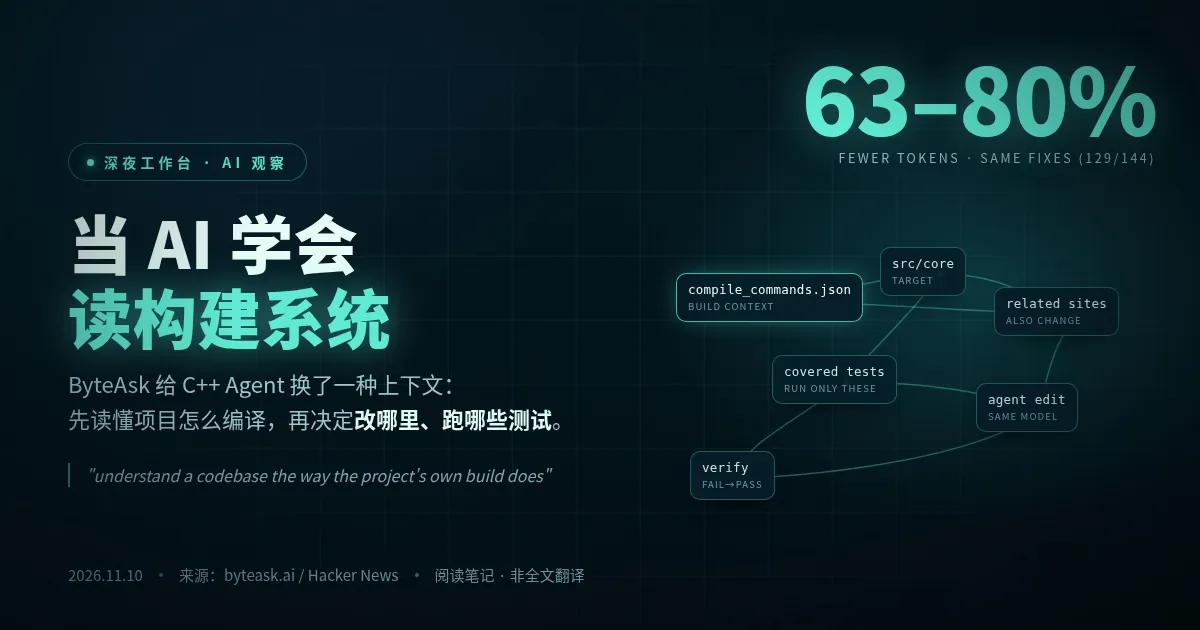
中文意思是:它的核心是一个上下文引擎,像项目自己的构建那样去理解代码库。具体来说,在模型开始之前,引擎先告诉它三件事:改动应该落在哪里、哪些相关位置可能需要同样的修改、哪些测试覆盖了这些地方;模型改完之后,再只跑这些被识别出来的测试来确认。
这里有两个关键设计。
一是上下文来自构建,而不是来自向量检索。 从公开仓库的复现说明看,ByteAsk Context 需要项目里有 origin 远端,以及由项目自己的 CMake 配置生成的 compile_commands.json,然后开启索引。这个选择很"老派",但很对:编译数据库记录的是这个项目真实编译每个翻译单元时用了什么参数、包含了哪些头文件。比起把代码切块做相似度搜索,它更接近"这段代码实际是怎么被构建出来的"。
二是验证只跑相关测试。 这既是它省 token 的来源,也是它最需要被审视的地方。只跑相关测试,能大幅缩短 Agent 的试错循环;但"相关"的判断一旦漏了,回归就会从缝隙里溜过去。
为了证明效果,作者的实验设置是相对克制的:72 个任务,分成"流行 C++ 项目里的 held-out issue"和"冷门 C++ 项目里的 issue",另加 5 个难题;两个 Agent 用同一个模型(论文所述为 GPT-6.1 Sol,medium effort)、同样的指令、45 分钟时限、同样的资源;判分标准是 fail-to-pass 测试全部通过、pass-to-pass 测试不能退化,而且判分在无网络的独立容器里做。这个判分口径比"看起来改对了"严格得多。
数据:同样的通过数,完全不同的成本
最抓人的结论是这一句:
Both agents fix the same number of runs in every set ... but ByteAsk uses 63–80% fewer tokens and costs 59–70% less.
中文意思是:在每一组任务里,两个 Agent 修好的运行数完全一样(合计 129/144),但 ByteAsk 用的 token 少 63% 到 80%,成本低 59% 到 70%。
公开仓库给出的分项数据更具体(以下数字来自原文与仓库 README,成本为按标价估算):
| 任务集 | 运行数 | Codex CLI token | ByteAsk token | token 节省 | 成本节省 |
|---|---|---|---|---|---|
| 流行 C++ 项目 held-out issue | 46 | 727k | 263k | 63.9% | 59.9% |
| 冷门 C++ 项目 issue | 98 | 2,296k | 457k | 80.1% | 70.1% |
| 两组汇总 | 144 | 1,795k | 395k | 78.0% | 68.1% |
| 难题 | 15 | 2,085k | 400k | 80.8% | 67.9% |
还有一个更有意思的细节:
The biggest savings come on little-known and hard C++ projects: about 80% fewer tokens.
中文意思是:最大的节省出现在冷门项目和难题上,token 大约少 80%。这其实符合直觉——越是没人写过、模型越不熟悉的代码库,越依赖"现场把这套构建关系讲清楚",而不是靠模型从训练记忆里猜。热门项目里模型见得多,上下文给不给,差距反而没那么大。
换句话说,这篇文章真正卖的不是"更聪明的模型",而是"更便宜的定位"。同样的模型、同样的通过数,差异全部来自上下文怎么给、验证怎么跑。
我的评论:这是"Agent 工程"的胜利,不是"模型能力"的胜利
我喜欢这篇研究的地方,是它把问题放对了位置。
现在很多 Agent 评测喜欢比"通过率",但通过率是个很粗的指标。两个系统都能修好 129 个 issue,一个花 395k token,一个花 1,795k token,在榜单上它们看起来一样强,在真实工作里它们的成本、延迟、稳定性完全不是一回事。ByteAsk 把"定位"和"验证"拆出来单独优化,这个思路比堆模型更接近工程现实。
它也给日常使用提了个醒:如果你想让 Agent 在陌生代码库里靠谱,先让它读懂构建,再让它写代码。 一个 compile_commands.json、一个能跑起来的本地环境、一组能被单独执行的测试,往往比多贴几段代码更有用。上下文不是越多越好,而是越"准"越好。
但它的局限也必须说清楚。
第一,厂商自评,且是 preprint。 没有同行评审,没有第三方复现。作者提供了复现脚本和数据,这是加分项,但在别人跑出同样的数字之前,这些结论只能算"作者报告的结果"。
第二,单一语言、单一模型。 C/C++ 的构建关系相对明确,换成动态语言、前端项目、或者 monorepo,compile_commands.json 这种"权威上下文"不一定存在。方法的可迁移性,文章没有回答。
第三,只跑相关测试是一把双刃剑。 省下来的 token,一部分来自更少的上下文,另一部分来自更少的测试执行。判分时用完整的 fail-to-pass / pass-to-pass 把关,能兜住实验里的漏检;但在真实项目里,如果你自己的测试覆盖本来就薄,"只跑相关测试"就可能把回归放过去。这个风险,最终还是要项目自己的测试质量来兜。
第四,冷门项目的数据要谨慎看。 冷门项目收益最大,但也意味着样本里"模型本来就不熟"的占比更高,结论对"热门项目日常使用"的 extrapolation 需要打点折扣。
第五,成本是按标价估算的。 token 省了 60% 到 80%,不代表账单一定同比例下降——缓存命中、批量折扣、重试策略都会改变最终数字。
对我们的实际启发
抛开厂商立场,这篇文章至少给了三条可以直接拿走的经验。
- 先修上下文,再修提示词。 让 Agent 知道"构建是怎么发生的",比反复润色指令更有效。
- 把验证做成闭环。 能自动跑的测试、能重复的环境、能对比的 diff,是 Agent 从"帮我写"变成"帮我交付"的分水岭。
- 用成本看 Agent,而不只看通过率。 同样的结果,token 和时间的差距,才是它能不能天天用的关键。
版权说明
本文是对上述原文的阅读笔记与评论,不是全文翻译,也不替代原文。文中引用的英文原句仅用于评论与说明,版权归原作者 Pratyush Saini、Anirudha Kulkarni 及 ByteAsk Research 所有;数据与图表以原文和其公开代码仓库为准。原文链接:https://byteask.ai/research/byteask-system-cpp 。如需完整内容,请阅读原文及论文 PDF。
评论