做结构化抽取的人,大概都经历过同一个瞬间:模型把一张发票解析得很漂亮,字段齐全、格式标准,直到你发现付款日期错了三天,而它给这个日期打了 0.99 的置信度。
问题从来不是"模型会不会写 JSON",而是它写完 JSON 之后,你拿什么去验收。
Cloudflare 今天在 Workers AI 文档里上了一个预览模型 Clairic(Hacker News 提交于 2026-11-12 00:42 UTC)。它没有走"更会聊天"的路线,而是把抽取这件事拆成三个可检查的东西:值、位置、不确定性。这篇笔记聊它的设计、一个发票示例,以及我在预览阶段不会相信它的地方。
原文信息
- 标题:Cloudflare Clairic: a single pass extraction model(文档页标题为 clairic)
- 作者:Cloudflare Workers AI 团队(文档未列出个人作者;Hacker News 提交者为 the_sleaze_)
- 发布时间:文档页未标注具体发布日期,模型状态为
preview;Hacker News 于 2026-11-12 00:42 UTC 出现提交(北京时间 08:42),本文按当天采集 - 原文链接:https://developers.cloudflare.com/workers-ai/models/clairic/
- HN 讨论:https://news.ycombinator.com/item?id=50461313
- 性质:厂商产品文档,不是独立评测;示例数据来自官方文档
先把前提说清楚:这是一篇文档精读,不是实测报告。我引用的是官方页面上的说明和示例,没有跑过真实业务数据。预览阶段的模型能力、价格和接口都可能变化,请以官方页面为准。
一、抽取任务的三个老问题
用通用聊天模型做抽取,通常会卡在三个地方。
第一是格式。 你要它输出 JSON,就得给 schema、处理截断、处理多出来的解释文字,还要为重试准备一套逻辑。模型越"话痨",解析越麻烦。
第二是证据。 它给了你一个值,但你说不清这个值来自原文哪一句。对账、审计、客服复核都需要"点一下跳到原文",而聊天模型的输出天然不带你回去。
第三是不确定性。 大多数模型无论多不确定,都会给你一个看起来完整的答案。它不会告诉你"这个字段原文没写",更不会说"我在猜"。
Clairic 的设计,基本是冲着这三点来的。
二、它做了什么
按文档描述,Clairic 是一个 System One 风格的模型:负责快速、单遍的抽取、计算、估计和预测,而不是多步推理的通用 Agent。你给它一段 state(文本或图片),再给一组强类型的 fields,它返回每个字段的答案。
几个关键设计:
强类型字段。 字段不是随便写个 JSON key,而是要声明类型,比如 text、number、date、list、estimate。数字还能声明小数位和单位,日期能借助 reference_date 补全省略的年份。类型越明确,后处理越少。
文本答案是原文的区间。 文档写得很直接:文本答案不是重新生成的一句话,而是 state 这段字符串里的一个 span,带字符偏移。这意味着结果可以高亮回原文,也可以做审计。
每个答案带不确定性。 输出里有 p_null(这个字段在输入中不存在的概率)和 confidence。当输入确实没有这个信息时,value 是 null,而不是编一个。
估计值给分布。 estimate 类型返回中位数、均值、p10 和 p90。它不假装自己知道精确值,而是给一个区间。对"账期大概多少天""这个工单大概要几小时"这类问题,区间比单点更有用。
字段多会拆并行 pass。 文档说明,放不进一次 8,192 token 的字段会被拆到并行的 pass 里。示例的 usage 里能看到 passes: 3——即使原文只有 61 个 token,字段 schema 也占了不少预算。这一点后面会展开。
此外它还支持最多 4 张图片、零数据保留(zero data retention),并标注为预览状态。文档同时给了按输入 token 计价的预览价格:每百万输入 token 0.10 美元。价格可能调整,接之前请自己核对。
三、一个发票示例里最值得看的细节
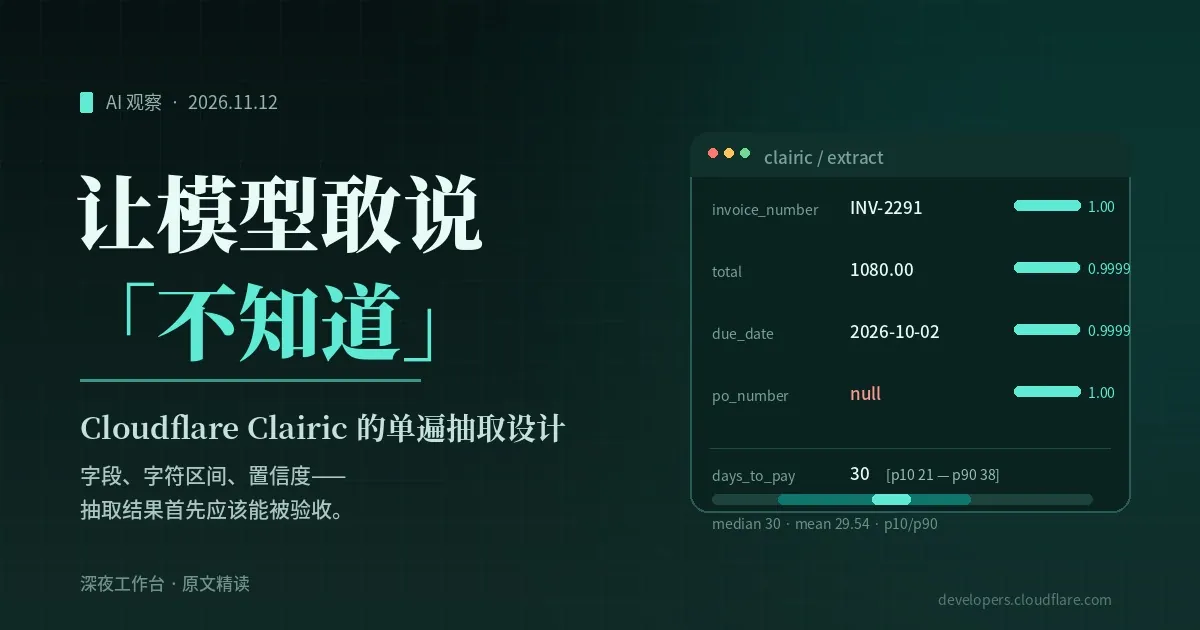
文档给出的示例是一张虚构发票:Northwind Supply 开给客户的 INV-2291,2026-09-02 开出,net 30,4 个托盘每托 250 美元,运费 80 美元。
模型要抽的字段包括发票号、到期日、总价、联系人、采购订单号和账期天数。结果大致是:
- 发票号
INV-2291,置信度 1.00,带字符区间; - 到期日
2026-10-02,由开票日加 net 30 推出来; - 总价
1080,把 4×250 和 80 运费算进去; - 联系人拆成
["Dana Ruiz", "Priya Shah"]; - 采购订单号
null,因为原文没有; - 账期天数是一个估计值,中位数 30,p10 到 p90 是 21 到 38。
最值得看的不是这些数字,而是 po_number 这一项:它的 value 是 null,p_null 约等于 1,但内部仍然有一个 guess,值指向了 INV-2291。
这个细节很有意思。模型并没有"不知道就不猜",它在内部产生了一个候选,但对外明确标记为不可用:value 为空,p_null 接近 1。猜测和结论被分开了。 对下游系统来说,这比一个自信的错值安全得多。
四、几段短引用
"Clairic is a System One-style model that can extract, compute, estimate, and forecast values from inputs."
它被定位成"快思考"的抽取器:单遍、面向字段,而不是一个什么都能聊的通用模型。这个定位决定了它不该被拿去做开放式推理。
"value is null when the input does not determine it."
输入没有写,就返回 null。这句话听起来简单,但它把"编造"从默认行为改成了需要避免的行为。
"Text answers are spans of this string."
文本答案必须是输入字符串的区间。抽取结果因此可以回溯,而不是一段无法定位的复述。
"Fields that do not fit next to the state in one 8,192-token pass are split across parallel passes."
字段放不下就拆并行 pass。灵活,但也意味着字段数量会直接影响调用次数和成本,"多抽几个字段"不是免费的。
五、我的判断:可拒绝、可回溯,比"更像人"重要
我越来越觉得,抽取类 AI 产品的分水岭不在"回答得多自然",而在三件事:
能不能拒绝。 字段不存在时敢返回 null,并且给出 p_null。这决定了它能不能直接接自动化流程。一个永远有答案的抽取器,只能当辅助;一个知道什么时候没答案的抽取器,才可能进流水线。
能不能回溯。 每个值带字符区间,人工复核时能直接定位原文。审计、对账、合规场景里,这比准确率多一个百分点更有价值。
能不能排序。 置信度和分布让系统可以分层处理:高置信度直接入库,中等置信度二次抽取,低置信度转人工。没有这个排序,所有结果都得人看一遍,自动化就失去了意义。
Clairic 把这三件事都放进了输出结构里。这是我认为它比"让聊天模型吐 JSON"更值得关注的原因。
六、预览阶段我不会相信的地方
但文档归文档,真要用,还有几个问题没有答案。
第一,置信度是否校准。 示例里的 0.9999 很好看,但那是演示数据。真实发票有模糊扫描、手写批注、跨页表格,模型给的 0.99 到底对应多少实际准确率,文档没有给评测。没有校准,置信度只是一个好看的排序信号,不能当阈值用。
第二,字段定义决定上限。 强类型是优点,也是负担。字段拆得太粗,抽出来没法用;拆得太细,pass 变多、成本上升。schema 设计仍然要人来负责,模型不会替你想清楚业务字段。
第三,多 pass 的成本。 示例里 61 token 的原文、472 token 的 schema,跑了 3 个 pass。字段一多,调用次数和延迟都会涨。文档说字段没有上限,但"没有上限"不等于"没有代价"。
第四,它只做抽取。 跨文档综合、开放式推理、多轮澄清,这些不是它的定位。把它当通用模型用,会失望;把它当抽取组件用,才合适。
第五,预览状态与供应商依赖。 文档明确写了按"现状"提供、可能随时停止或调整,也不承诺赔偿。对一个要进生产流程的组件来说,这是需要评估的风险。零数据保留是加分项,但合规确认仍然要做。
第六,文档没有发布日期。 我无法确认这个页面是什么时候更新的,也就无法判断示例对应哪个版本。对预览产品来说,版本可追踪性本身就是一个工程问题。
七、如果我要接它,会先做这几件事
- 选 10 到 20 个高频字段,拿 50 到 100 份真实文档做小样本评测,先看
value的准确率,再看p_null的表现。 - 把 span 映射回原文,做一个能高亮定位的复核界面。没有这个界面,字符区间就浪费了。
- 设两条阈值:
p_null高于阈值直接转人工;confidence低于阈值触发二次抽取或换模型。 - 记录每次调用的
passes和 token 用量,按真实文档估算单页成本,而不是按示例里的 61 token 估算。 - 不把演示里的 0.9999 当成 SLA。预览产品的第一个月,应该当成灰度期。
写在最后
Clairic 让我感兴趣的地方,不是它"更准",而是它把抽取结果做成了一个可以被工程系统消费的对象:有类型、有位置、有不确定性、有拒绝。
这几年我们习惯了让模型"给出答案"。但真正进入业务流程的 AI,往往要先学会另一件事:在不确定的时候,明确地说不确定。
抽取工具成熟的标志,大概不是它多会写,而是它敢说"这里我不知道"。
版权说明
本文为原文精读与个人评论,原文版权归 Cloudflare 所有。文中引用的英文原句、接口说明与示例数据均来自 Cloudflare Workers AI 官方文档,仅用于说明与评论,未做全文翻译或大段复制。示例中的发票与公司信息为官方文档的演示数据。原文链接:https://developers.cloudflare.com/workers-ai/models/clairic/
评论